Chat med dokumenter
Neste steg i informasjonsbehandling
I stedet for å stole på offentlige datasett og generell kunnskap, genererer "Chat med Dokumenter" kontekstspesifikke svar og analyser basert på dine betrodde interne kilder. Last opp dine dokumenter og bruk disse dokumentene som grunnlag for å besvare spørsmål i chatten!
Løsning av databegrensninger
Når du stiller spørsmål til en språkmodell, er du avhengig av datasettet modellen er trent på. Dette er vanligvis informasjon hentet fra internett. Ikke-offentlige kilder er sannsynligvis ikke i dette datasettet. Ved å bruke dokumentene dine som kilde for samtalen, vet du at modellen har informasjonen du trenger for å besvare spørsmålene dine.
Muligheter med dine dokumenter
Du kan stille spørsmål om dokumentene dine, som å nevne hovedpunktene i et dokument eller oppsummere dokumentet. Du kan også få modellen til å utføre spesifikke analyser ved hjelp av ditt eget datasett.
Ulemper med dokumentbasert chat
Opplasting av dokumenter og behandlingen av dem er ekstra trinn som du ikke trenger å gjøre hvis du kan få et tilfredsstillende svar uten konteksten av spesifikk informasjon. Det tar også lengre tid å generere et svar fordi nødvendig informasjon må hentes fra dokumentet før forespørselen kan sendes til språkmodellen.
Se hvilke kilder som er lest
Under et svar kan Kilder vise hvilket innhold modellen har brukt: Full tekst, Utvalg, Sammendrag, Ufullstendig behandlet eller Ikke lest. En vedlagt fil er altså ikke automatisk lest i sin helhet. Kontroller denne informasjonen før du bruker et svar som må dekke alle deler av en fil.
Ved et utvalg eller forkortet resultat kan du be mer presist om et kapittel eller de gjenværende delene. Ved ufullstendig behandling kontrollerer du først filstatusen. En assistentadministrator kan under Kildetekst velge Full kildetekst kreves: da brukes ikke sammendrag som erstatning for teksten. Store kilder kan leses i deler og gi høyere forbruk. Også da må kildevarslingen fortsatt kontrolleres.
Passende modeller for dokumentbasert chat
Velg en språkmodell av høy kvalitet med tilstrekkelig kontekstkapasitet fra den sentrale modellkatalogen for å chatte med dokumenter.
Passende modeller er modeller med tilstrekkelig kontekstplass og god dokumentanalyse, slik som de høykvalitetsmodellene fra OpenAI, Claude, Google eller europeisk AI.
Velg ett eller flere dokumenter
Du kan slå på filmodus ved å klikke på binderasten til høyre for spørsmålspanelet. Du kan velge opptil 10 filer å chatte med.
Når du begynner å chatte med dokumenter, blir det kontrollert om språkmodellen er egnet for chat med dokumenter. Hvis ikke, blir det automatisk valgt et passende modell fra den aktuelle katalogen.
Du chatter med disse dokumentene så lenge filmodus er aktiv.
Behandle per fil
I tillegg til chat med dokumenter tilbyr AI-Corporate også muligheten til å bruke en egen prompt på hvert dokument og motta individuelle svar. Denne funksjonen kalles Behandle per fil.
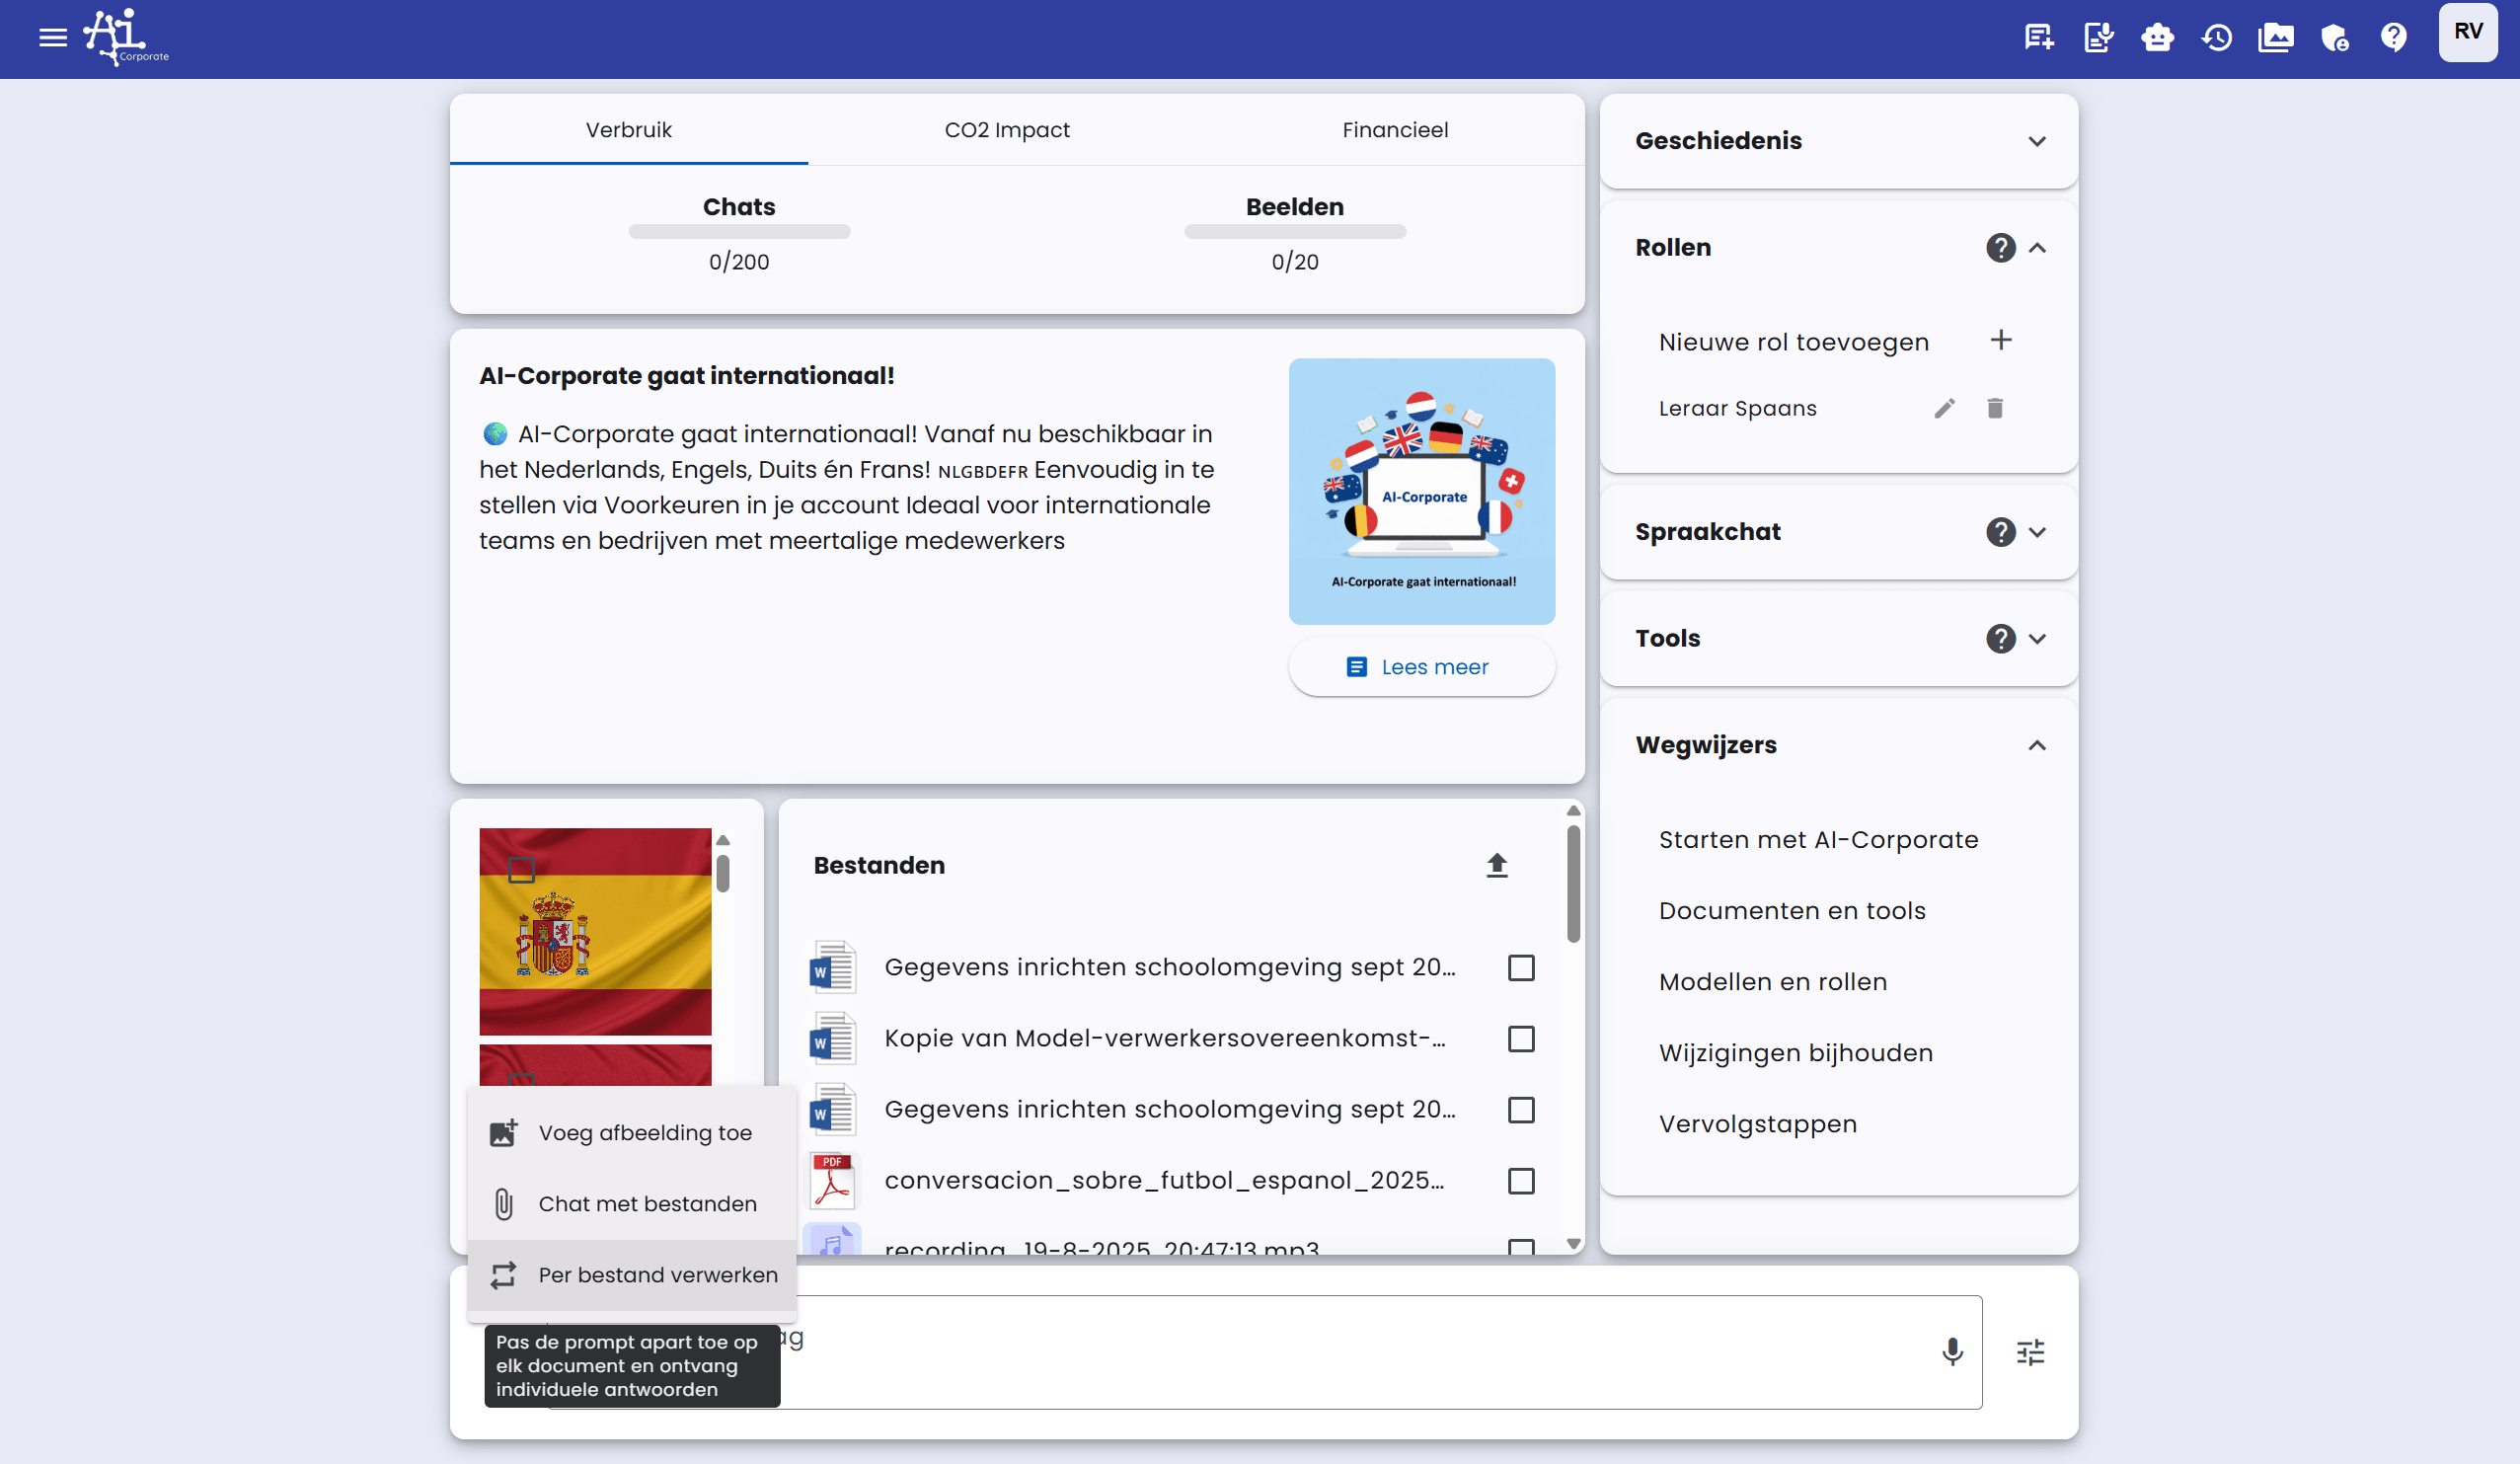
Denne funksjonen kan brukes i kombinasjon med "Chat med filer".
Mulig scenario
Et praktisk eksempel på bruk av "Behandle per fil":
- Du laster opp et referancedokument (for eksempel en kontraktsmal) og aktiverer det i Chat med filer
- Du laster opp flere dokumenter som skal analyseres og aktiverer dem i Behandle per fil
- Du formulerer en prompt som anvendes på alle filer individuelt
På denne måten kan du for eksempel få alle kontrakter analysert automatisk basert på referans mal.
Det gjelder en maksgrense på 30 filer for funksjonen "Behandle per fil".
Støttede filtyper
AI-Corporate støtter ulike filtyper for chat med dokumenter:
- PDF-filer som ender på .pdf
- Word-filer som ender på .docx
- CSV-filer som ender på .csv
- JSON-filer som ender på .json
- Tekstfiler som ender på .txt
- Lyd- og videofiler med utvidelsene 'mp3', 'mp4', 'mpeg', 'mpga', 'm4a', 'wav' eller 'webm'
Chatte med lyd- eller videofiler
For lyd- eller videofiler transkriberer AI-Corporate først filen via konfigurert transkripsjonsleverandør, for eksempel OpenAI eller Europeisk AI. De konkrete modellene kommer fra den sentrale modellkatalogen.
Ved samtaler kan transkripsjonen inneholde tidsblokker og taleretiketter når valgt modell støtter det. Deretter kan en egnet tekstmodell rette tegnsetting, stavemåte, taleretiketter og faguttrykk.
Etter transkripsjon brukes samme prosess som for PDF- eller Word-dokumenter.
Lyd- og videomodeller har leverandør- og modellavhengige grenser for filstørrelse og varighet. Lange filer kan derfor behandles annerledes enn korte. Hvis behandlingen mislykkes, kontroller filstatus og prøv igjen eller lever filen i mindre deler.
Filer du kan laste ned som eksempler
Eksempel på bedriftsrapport Eksempel prosjektdokument Stort historisk dokument
Behandle og gjenbruke filer
Filer du laster opp blir først behandlet før AI-Corporate kan bruke innholdet i chatten, assistenter og arbeidsflyter. Hvis behandlingen mislykkes, får filen en feilstatus og du kan laste den opp på nytt eller få den behandlet på nytt fra Filbehandling.
For PDF-er kan AI-Corporate bruke den vanlige tekstlaget og, når det er nødvendig, utføre en mer omfattende PDF-analyse. Dette er nyttig for skannede dokumenter, utfylte skjemaer, håndskrevne notater, omrissede eller understrekte valg, tabeller og visuell informasjon. Store PDF-er kan deles opp i mindre deler under behandlingen.
Når et skjema eller en arbeidsflyt ber om en fil, kan du laste opp en ny fil eller velge en eksisterende fil via mediehåndtereren. Filer som blir lagt til via et slikt skjema, er tilgjengelige for assistenten i den aktuelle chatten, men blir ikke automatisk valgt for vanlige chat-spørsmål.
Markdown-filer med ".md"-utvidelsen støttes også.
Sentral kunnskapsbase
Publiserte dokumenter søkes automatisk innenfor organisasjonens eller skolens omfang og forblir organisasjonens eiendom.
- Opprett Markdown-dokument
- Legg til kildefil
- Importer OKF-pakke / Eksporter OKF-pakke
- Publiseringsstatus: Utkast, Publisert, Arkivert
- Omfang: Hele organisasjonen / Valgte skoler
Skoleadministratorer kan bare administrere dokumenter for sine egne skoler; organisasjonsadministratorer kan også administrere kunnskap for hele organisasjonen.
Bruk YAML-frontmatter og vanlige Markdown-lenker for portabel OKF-kunnskap.
