Чат з документами
Наступний крок у обробці інформації
Замість того, щоб поклакатись на публічні набори даних та загальні знання, «Чат з документами» генерує контекстуально специфічні відповіді та аналізи на основі ваших надійних внутрішніх джерел. Завантажуйте свої документи та використовуйте їх як основу для відповідання на запитання у чаті!
Розв’язання обмежень даних
Якщо ви ставите запитання мовній моделі, ви залежить від набору даних, на якому тренована модель. Зазвичай це інформація з Інтернету. Непублічні джерела, швидше за все, відсутні у цьому наборі даних. Використовуючи ваші документи як джерело для чату, ви гарантуєте, що модель має ту інформацію, яка потрібна для відповіді на ваші запитання.
Можливості з вашими документами
Ви можете ставити запитання щодо ваших документів, наприклад викладити основні пункти документа або підсумувати документ. Також ви можете доручити моделі виконати конкретні аналізи з використанням вашого власного набору даних.
Недоліки чатування за документами
Завантаження документів та їх обробка — це додаткові кроки, які не потрібні, якщо ви можете отримати в цілому відповіді без контексту конкретної інформації. Також відповідь може генеруватися довше, оскільки спочатку потрібно витягти необхідну інформацію з документа, перш ніж запит буде надісланий мовній моделі.
Перевірка, які джерела було прочитано
Під відповіддю Джерела може показувати, який вміст використала модель: Повний текст, Вибірка, Стислий виклад, Оброблено не повністю або Не прочитано. Отже, вкладений файл не обов’язково було прочитано повністю. Перевіряйте цю інформацію, перш ніж використовувати відповідь, яка має охоплювати всі частини файлу.
У разі вибірки або скороченого результату можна точніше попросити про розділ або про решту частин. За неповної обробки спочатку перевірте стан файлу. Адміністратор асистента може в Вихідний текст вибрати Потрібен повний вихідний текст: тоді підсумки не використовуються як заміна тексту. Великі джерела можуть читатися частинами і спричиняти більше витрат. І в такому разі потрібно перевіряти повідомлення про джерела.
Підходящі моделі для документно-орієнтованого чатування
Для роботи з документами виберіть із центрального каталогу якісну мовну модель із достатнім контекстним вікном.
Підходящі моделі — це моделі з достатнім контекстним простором та гарним аналізом документів, такі як високоякісні моделі від OpenAI, Claude, Google або Європейський AI.
Вибір одного або кількох документів
Ви можете увімкнути режим файлів, клікнувши на скріпку праворуч від панелі запитів. Можете обрати до 10 файлів для чатування.
Коли ви починаєте чатувати з документами, перевіряється, чи підходить мовна модель для чатування з документами. Якщо ні — автоматично обирається відповідна модель із актуального каталогу.
Ви чатуєте із цими документами, доки режим файлів увімкнено.
Обробка за кожним файлом
Крім чатування з документами, AI-Corporate також надає можливість застосувати окремий запит до кожного документа та отримати індивідуальні відповіді. Ця функція називається Обробка за кожним файлом.
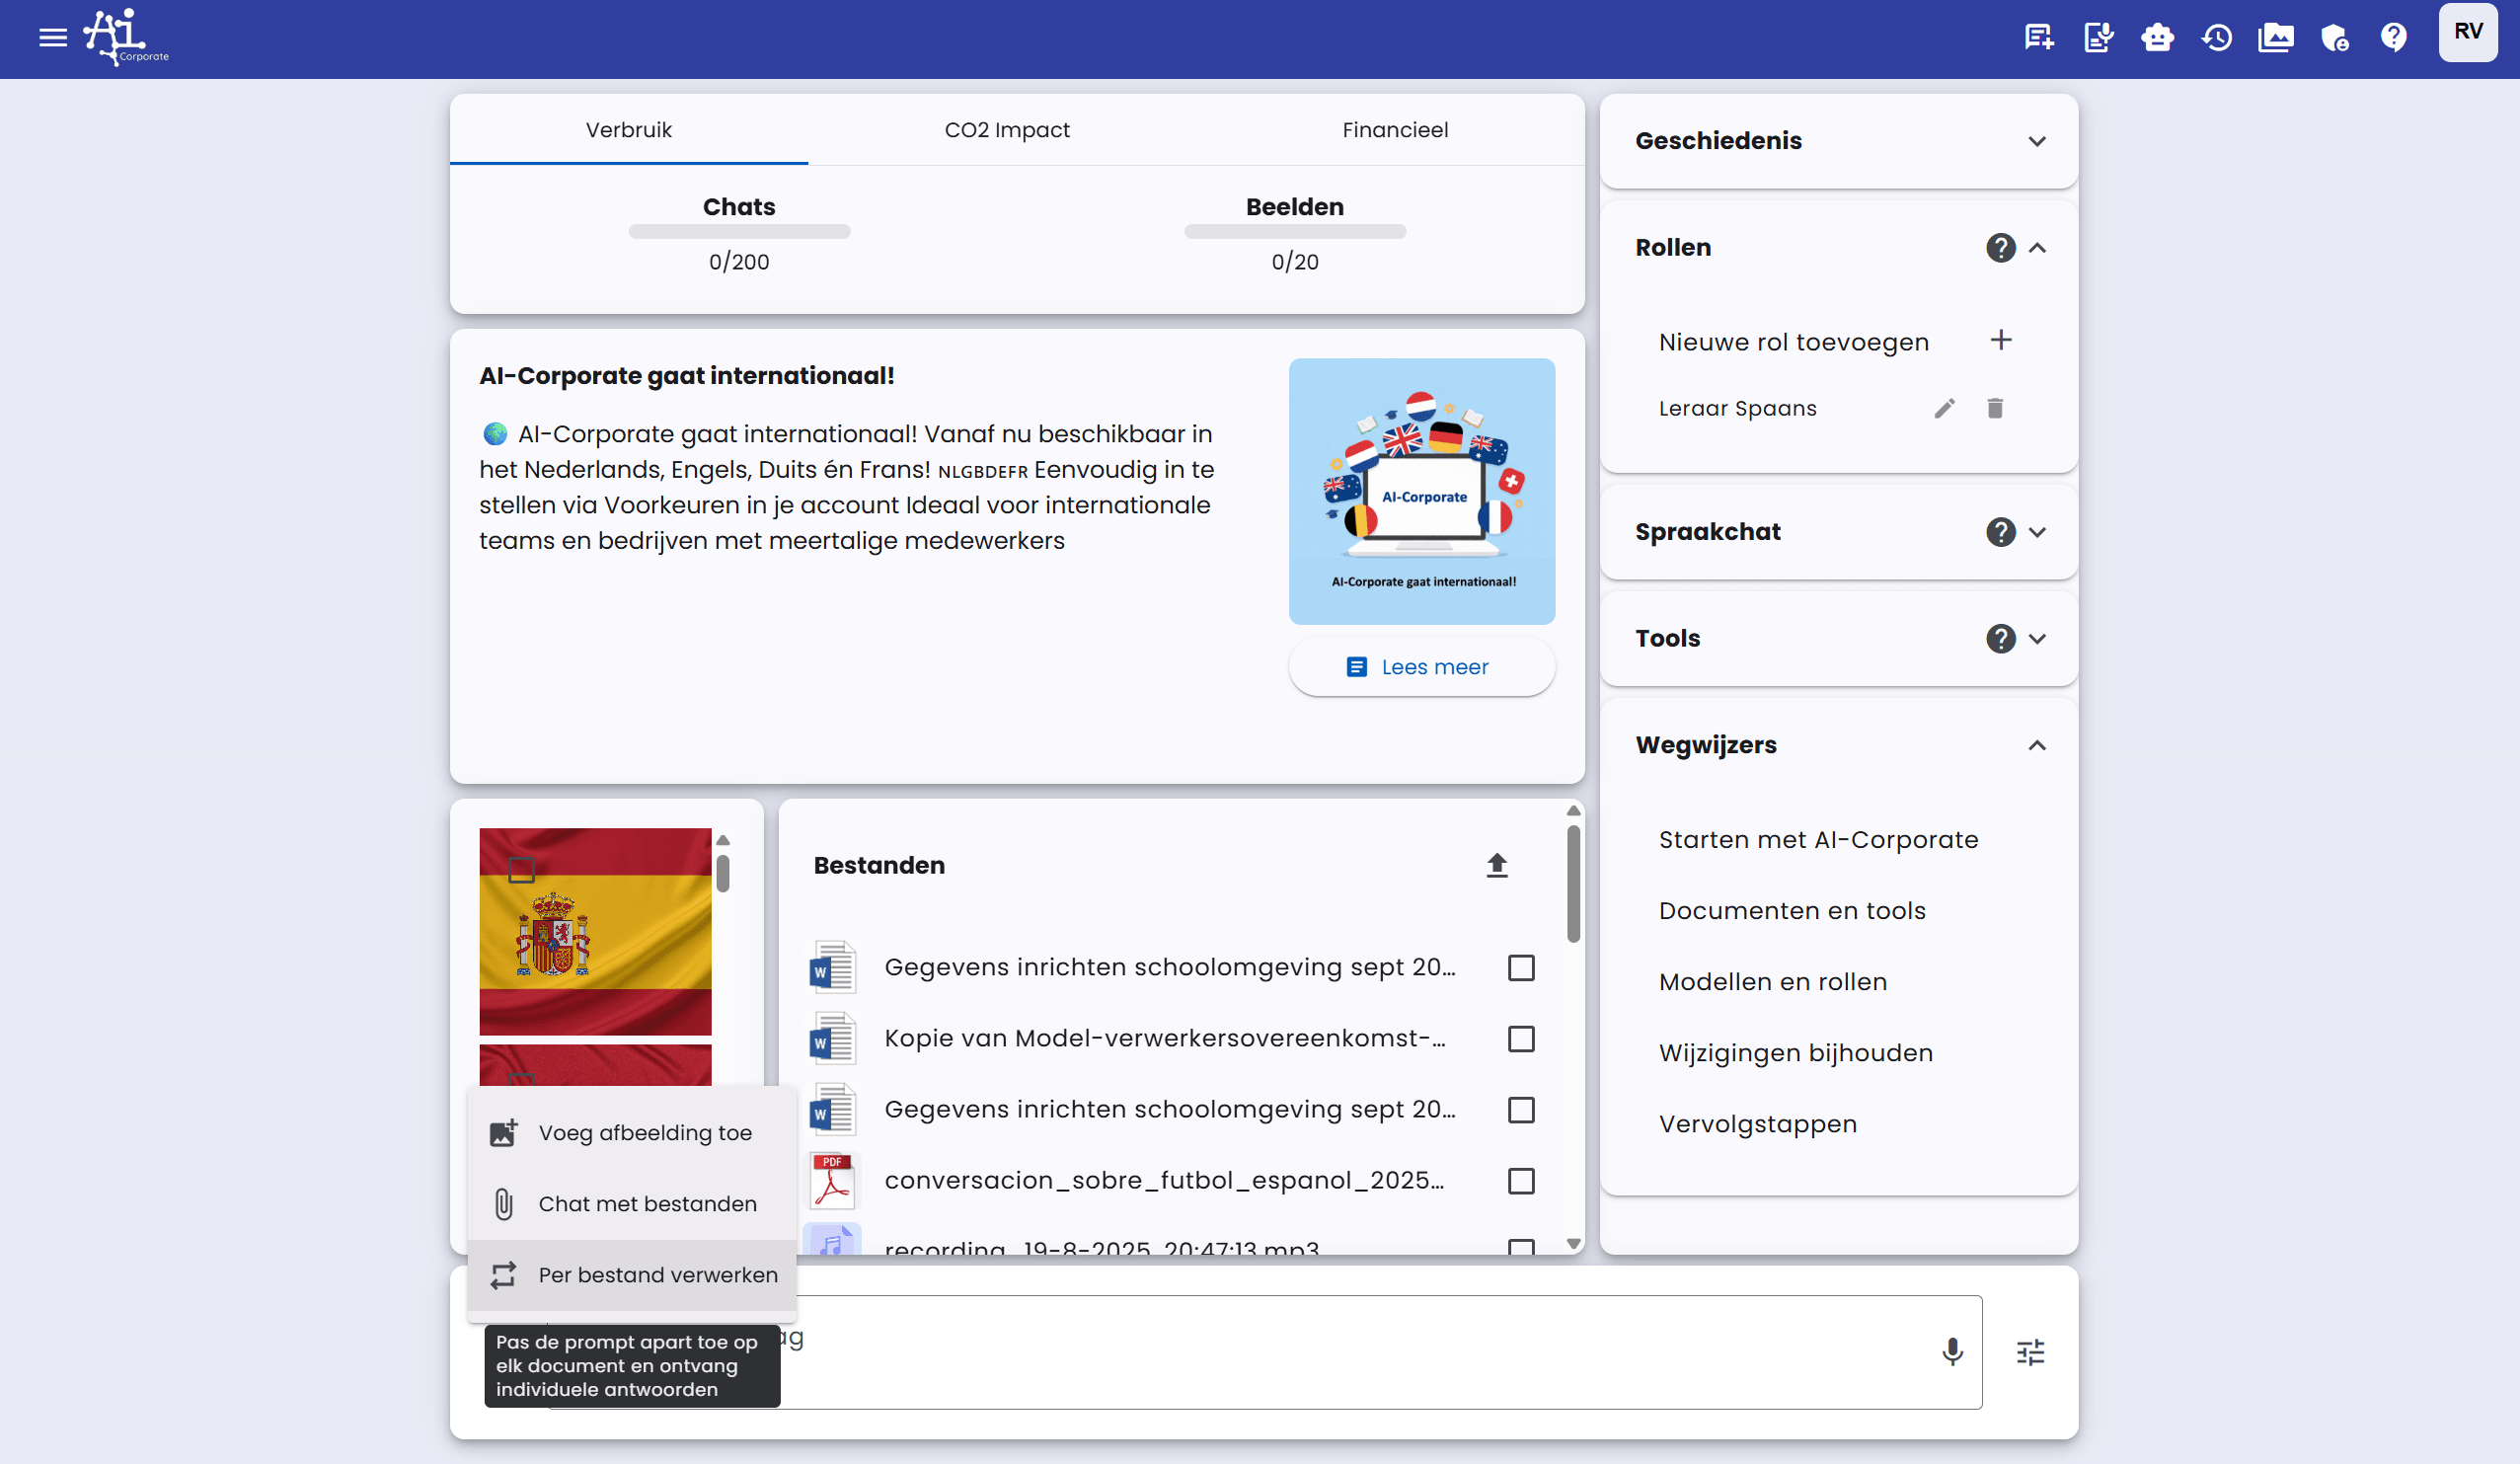
Ця функція може використовуватися у поєднанні з «Чат з файлами».
Можливий сценарій
Практичний приклад використання «Обробка за кожним файлом»:
- Ви завантажуєте референтний документ (наприклад шаблон контракту) і вмикаєте його в Чат із файлами
- Ви завантажуєте кілька документів, які потрібно проаналізувати, і вмикаєте їх у Обробку за кожним файлом
- Формулюєте запит, що застосовується до всіх файлів індивідуально
Так ви можете, наприклад, автоматично проаналізувати всі контракти за зразком-референсом.
Є обмеження — 30 файлів для функции «Обробка за кожним файлом».
Підтримувані типи файлів
AI-Corporate підтримує різні типи файлів для чатування з документами:
- PDF файли з розширенням .pdf
- Word файли з розширенням .docx
- CSV файли з розширенням .csv
- JSON файли з розширенням .json
- Текстові файли з розширенням .txt
- Аудіо та відео файли з розширеннями 'mp3', 'mp4', 'mpeg', 'mpga', 'm4a', 'wav' або 'webm'
Чат з аудіо- або відеофайлами
AI-School спочатку транскрибує аудіо- та відеофайли налаштованим постачальником транскрипції. У розмовах результат може містити часові блоки та мітки спікерів. Потім відповідна текстова модель може виправити пунктуацію, правопис, мітки спікерів і фахові терміни. Довгі файли можуть оброблятися інакше через обмеження постачальника та моделі.
Центральна база знань
Опубліковані документи автоматично шукаються в межах організації або школи й залишаються власністю організації.
- Створити документ Markdown
- Додати вихідний файл
- Імпортувати пакет OKF / Експортувати пакет OKF
- Статус публікації: Чернетка, Опубліковано, Архівовано
- Область: Уся організація / Вибрані школи
Адміністратори шкіл можуть керувати документами лише для своїх шкіл; адміністратори організації також можуть керувати знаннями на рівні всієї організації.
Використовуйте YAML-frontmatter і звичайні посилання Markdown для переносних знань OKF.
