Rozmowa z dokumentami
Kolejny krok w przetwarzaniu informacji
Zamiast polegać na publicznych zbiorach danych i ogólnej wiedzy, „Rozmowa z dokumentami” generuje kontekstowo-specyficzne odpowiedzi i analizy na podstawie Twoich zaufanych źródeł wewnętrznych. Prześlij swoje dokumenty i używaj ich jako podstawy do odpowiadania na pytania w czacie!
Rozwiązywanie ograniczeń danych
Jeżeli zadajesz pytania modelowi językowemu, polegasz na zestawie danych, na którym model był trenowany. Zazwyczaj są to informacje pozyskane z Internetu. Prywatne źródła najprawdopodobniej nie znajdują się w tym zestawie danych. Korzystając z Twoich dokumentów jako źródła do czatu, masz pewność, że model posiada informacje, których potrzebujesz do odpowiedzi na Twoje pytania.
Możliwości z Twoimi dokumentami
Możesz zadawać pytania dotyczące Twoich dokumentów, takie jak wymienienie najważniejszych punktów dokumentu lub zsumowanie dokumentu. Możesz też zlecić modelowi wykonanie konkretnych analiz na Twoim własnym zestawie danych.
Wady czatowania opartego na dokumentach
Przesłanie i przetwarzanie dokumentów to dodatkowe kroki, których nie musisz wykonywać, jeśli możesz uzyskać dobrą odpowiedź bez kontekstu konkretnych informacji. Generowanie odpowiedzi zajmuje też więcej czasu, ponieważ najpierw trzeba pozyskać niezbędne informacje z dokumentu, zanim zapytanie zostanie wysłane do modelu językowego.
Sprawdzanie, jakie źródła zostały odczytane
Pod odpowiedzią Źródła mogą pokazywać, jaką treść wykorzystał model: Pełny tekst, Wybór, Streszczenie, Przetworzono niekompletnie lub Nieprzeczytany. Dołączony plik nie jest więc automatycznie w całości odczytywany. Sprawdź te informacje, zanim użyjesz odpowiedzi, która musi uwzględniać wszystkie części pliku.
W przypadku wyboru lub skróconego wyniku możesz dokładniej poprosić o rozdział lub pozostałe części. Przy niepełnym przetworzeniu najpierw sprawdź status pliku. Administrator asystenta może w opcji Tekst źródłowy wybrać Wymagany pełny tekst źródłowy: wtedy podsumowania nie są używane jako zamiennik tekstu. Duże źródła mogą być odczytywane częściami i generować większe zużycie. Również wtedy konieczne jest sprawdzenie komunikatu o źródłach.
Odpowiednie modele do czatowania opartego na dokumentach
Do rozmów z dokumentami wybierz z centralnego katalogu modeli wysokiej jakości model językowy z wystarczająco dużym oknem kontekstowym.
Odpowiednie modele to takie, które mają wystarczająco dużo miejsca na kontekst i dobre analizowanie dokumentów, takie jak wysokiej jakości modele od OpenAI, Claude, Google lub europejskiej AI.
Wybierz jeden lub więcej dokumentów
Możesz włączyć tryb plików, klikając ikonę spinacza po prawej stronie paska pytań. Możesz wybrać do 10 plików do czatowania.
W momencie rozpoczęcia czatowania z dokumentami sprawdzane jest, czy model językowy jest odpowiedni do czatowania z dokumentami. Jeżeli nie, automatycznie zostanie wybrany odpowiedni model z aktualnego katalogu.
Rozmawiasz z tymi dokumentami tak długo, jak tryb plików jest włączony.
Przetwarzanie per plik
Oprócz czatowania z dokumentami, AI-Corporate oferuje również możliwość zastosowania promptu osobno do każdego dokumentu i otrzymania odpowiedzi indywidualnie. Ta funkcja nazywa się Przetwarzanie per plik.
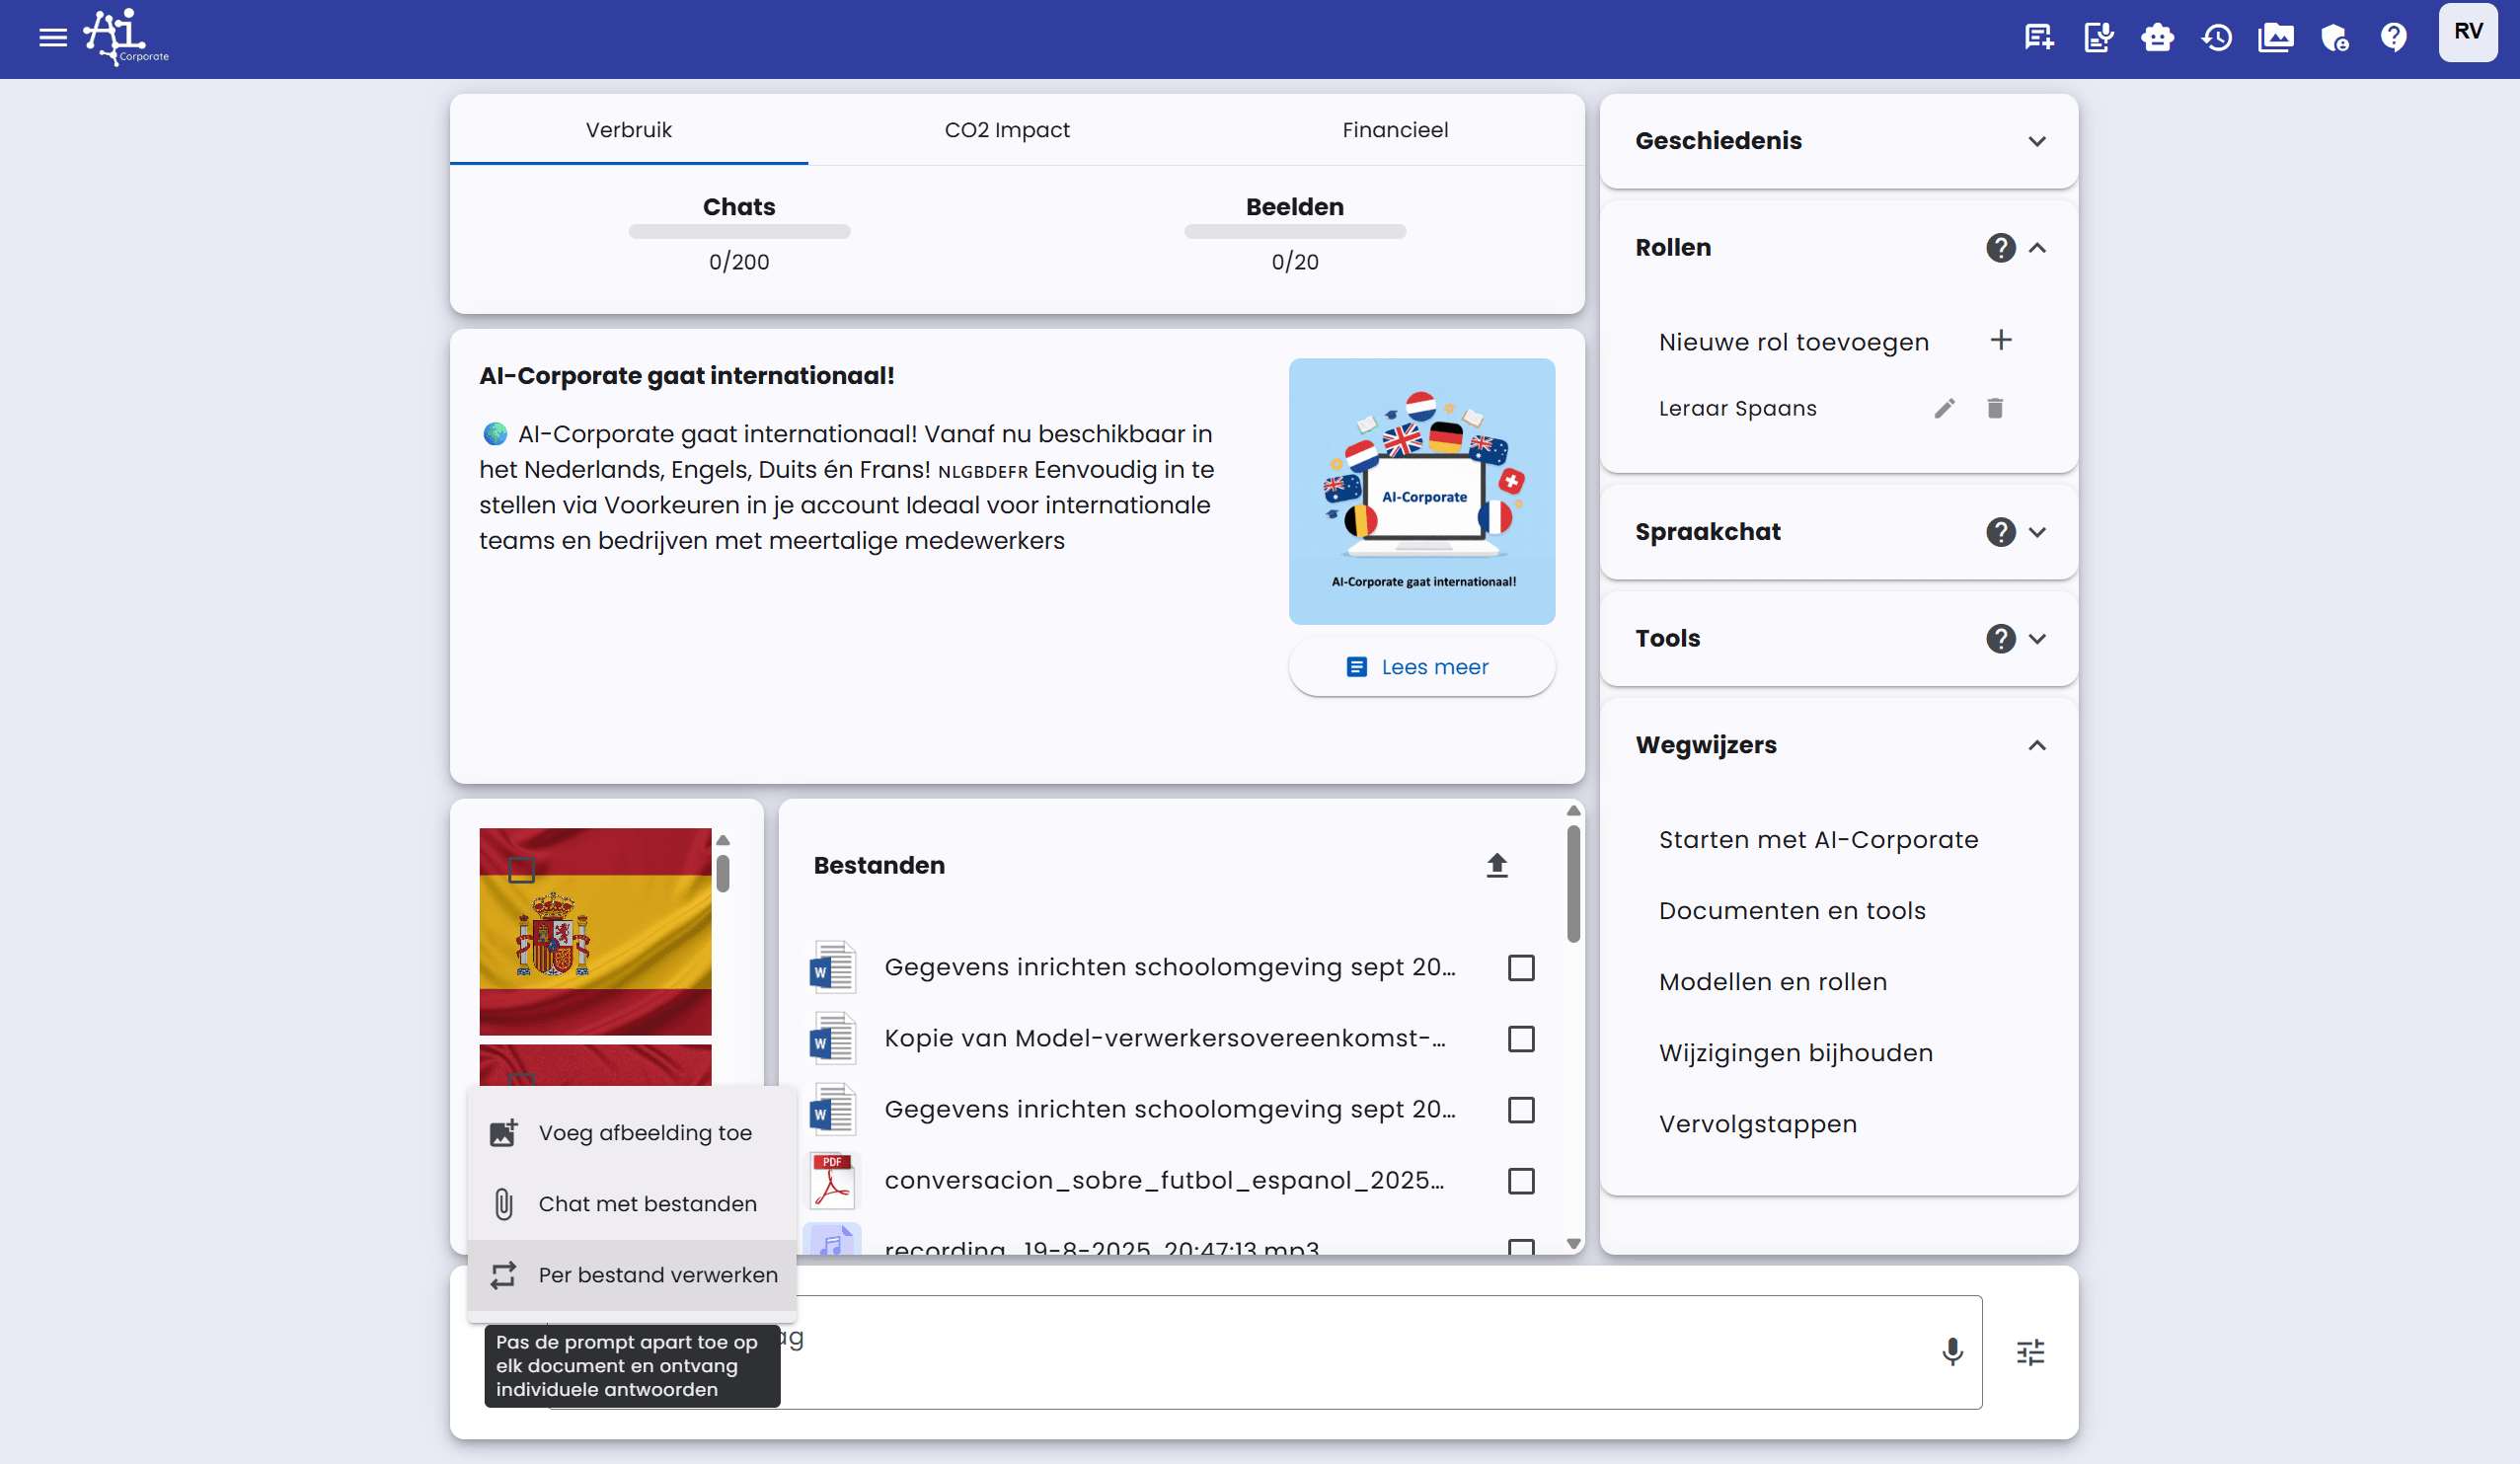
Ta funkcja może być używana w połączeniu z „Rozmową z plikami”.
Scenariusz możliwy
Praktyczny przykład użycia „Przetwarzanie per plik”:
- Prześlesz referencyjny dokument (na przykład szablon umowy) i włączysz go w Rozmowę z plikami
- Prześlesz kilka dokumentów do analizy i włączysz je w Przetwarzanie per plik
- Sformułujesz prompt, który będzie stosowany do każdego pliku indywidualnie
W ten sposób możesz na przykład automatycznie przeanalizować wszystkie umowy na podstawie referencyjnego szablonu.
Obowiązuje maksymalnie 30 plików dla funkcji „Przetwarzanie per plik”.
Obsługiwane typy plików
AI-Corporate obsługuje różne typy plików do czatowania z dokumentami:
- Pliki PDF o rozszerzeniu .pdf
- Pliki Word o rozszerzeniu .docx
- Pliki CSV o rozszerzeniu .csv
- Pliki JSON o rozszerzeniu .json
- Pliki tekstowe o rozszerzeniu .txt
- Pliki audio i wideo o rozszerzeniach 'mp3', 'mp4', 'mpeg', 'mpga', 'm4a', 'wav' lub 'webm'
Czat z plikami audio lub wideo
AI-School najpierw transkrybuje pliki audio i wideo przy użyciu ustawionego dostawcy transkrypcji. Przy rozmowach wynik może zawierać bloki czasowe i etykiety mówców. Następnie odpowiedni model tekstowy może poprawić interpunkcję, pisownię, etykiety mówców i terminy fachowe. Długie pliki mogą być przetwarzane inaczej niż krótkie ze względu na limity dostawcy i modelu.
Centralna baza wiedzy
Opublikowane dokumenty są automatycznie przeszukiwane w zakresie organizacji lub szkoły i pozostają własnością organizacji.
- Utwórz dokument Markdown
- Dodaj plik źródłowy
- Importuj pakiet OKF / Eksportuj pakiet OKF
- Stan publikacji: Wersja robocza, Opublikowano, Zarchiwizowano
- Zakres: Cała organizacja / Wybrane szkoły
Administratorzy szkół mogą zarządzać dokumentami tylko dla swoich szkół; administratorzy organizacji mogą również zarządzać wiedzą obejmującą całą organizację.
Użyj nagłówka YAML i zwykłych łączy Markdown dla przenośnej wiedzy OKF.
