聊天與文件
資訊處理的下一步
與其依賴公開數據集和一般知識相比,“與文件聊天”會根據你可信的內部資源生成特定語境的回答與分析。上傳你的文件,並使用這些文件作為聊天中回答問題的基礎!
解決數據限制
當你向語言模型提出問題時,你依賴於模型訓練時所使用的數據集。通常這是從網際網路取得的資訊。不公開來源很可能不包含在該數據集中。將你的文件作為聊天的來源,你可以確保模型具備回答你問題所需的資訊。
與你的文件相關的能力
你可以對你的文件提出問題,例如列出文件的要點或對文件進行摘要。也可以讓語言模型根據你的自己的數據集執行特定分析。
文件為基礎的聊天的缺點
上傳文件並對其進行處理需要額外的步驟,若你在沒有特定資訊背景的情況下也能得到不依賴上下文的良好回答,則無需這些步驟。此外,因為必須先從文件中取出所需資訊再送出請求給語言模型,生成回答的時間也較長。
查看已读取哪些来源
在回答下方,来源会显示模型使用了哪些内容:全文、节选、摘要、处理不完整或未读取。因此,附加文件并不会自动被完整读取。在使用需要涵盖文件所有部分的答案之前,请先检查此信息。
对于选择内容或截断结果,你可以更有针对性地要求某一章节或其余部分。对于处理不完整的情况,先检查文件状态。助手管理员可以在 源文本 中选择 要求完整源文本:这样摘要不会被用作正文的替代。大型来源可能会分段读取并消耗更多额度。即便如此,仍然需要检查来源提示。
適合文件為基礎的聊天的模型
與文件聊天時,請從中央模型目錄中選擇具有足夠上下文容量的高品質語言模型。
適合的模型具備足夠的上下文容量與良好的文件分析能力,例如 OpenAI、Claude、Google 的高品質模型,或歐洲的 AI 模型。
選擇一個或多個文件
你可以通過在問題欄右側點擊回形針圖示開啟檔案上傳模式。最多可選擇 10 個檔案進行聊天。
當你開始與文件聊天時,系統會檢查該語言模型是否適合用於文件聊天。如果不符合,將自動從當前目錄中選擇一個適合的模型。
在開啟檔案模式時,你就可以與這些文件聊天。
單檔處理
除了文件聊天外,AI-Corporate 也提供對每個檔案單獨套用提示並得到個別回覆的功能。此功能稱為「逐檔處理」。
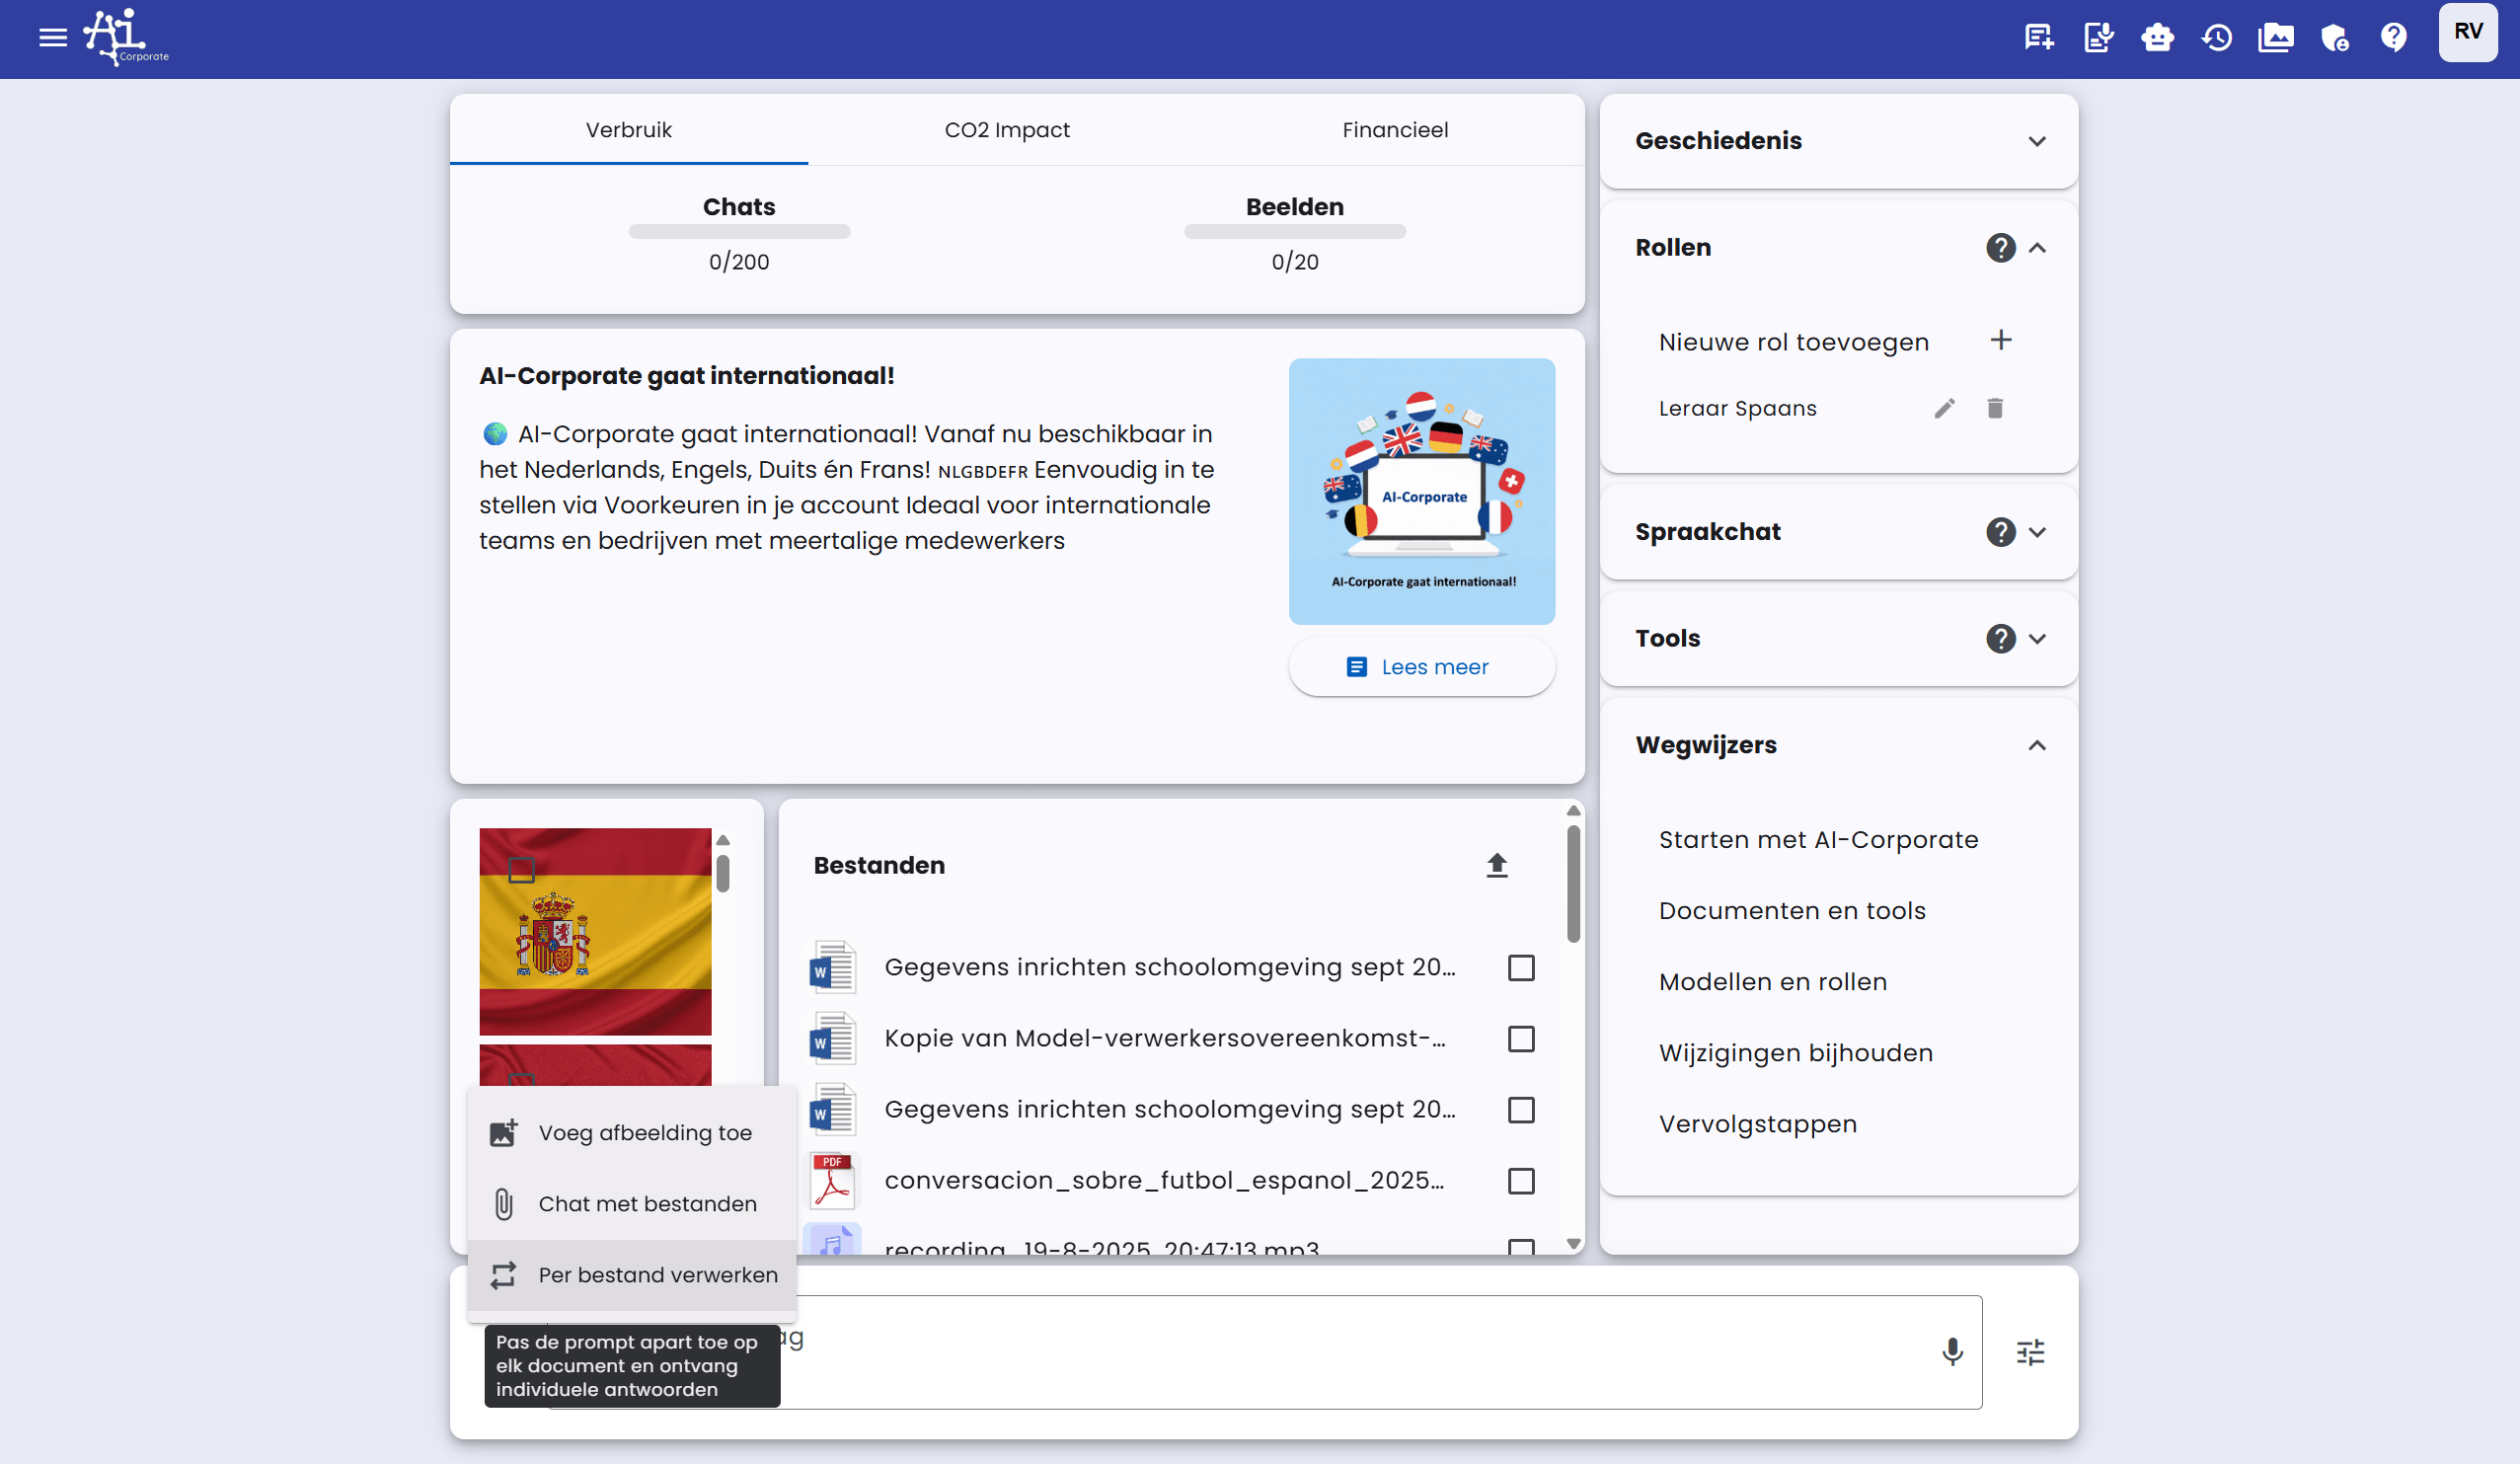
此功能可與「與檔案聊天」結合使用。
可能的場景
使用「逐檔處理」的實用範例:
- 你上傳參考檔案(例如合同樣本),並在「與檔案聊天」中打開它
- 上傳多個需要分析的檔案,並開啟「逐檔處理」
- 你提出一個會套用於所有檔案的提示,逐一套用於各檔案
透過這種方式,你可以讓所有合約自動根據參考樣本進行分析。
「逐檔處理」功能有 30 檔的上限。
支援的檔案類型
AI-Corporate 支援多種檔案類型以進行文件聊天:
- .pdf 的 PDF 檔
- .docx 的 Word 檔
- .csv 的 CSV 檔
- .json 的 JSON 檔
- .txt 的純文字檔
- 擴展名為 'mp3', 'mp4', 'mpeg', 'mpga', 'm4a', 'wav' 或 'webm' 的音訊與視訊檔
与音频或视频文件聊天
AI-School 会先用设置好的转录提供商把音频和视频文件转为文本。对于对话,结果可能包含时间块和说话人标签。之后可以用合适的文本模型修正标点、拼写、说话人标签和专业术语。由于提供商和模型限制,长文件的处理方式可能不同于短文件。
中央知识库
已发布的文档会在其组织或学校范围内自动检索,并始终归组织所有。
- 创建 Markdown 文档
- 添加源文件
- 导入 OKF 包 / 导出 OKF 包
- 发布状态: 草稿, 已发布, 已归档
- 范围: 整个组织 / 所选学校
学校管理员只能管理自己学校的文档;组织管理员还可以管理覆盖整个组织的知识。
使用 YAML 前置元数据和普通 Markdown 链接创建可移植的 OKF 知识。
