ドキュメントを用いたチャット
情報処理の次のステップ
公開データセットや一般的な知識だけに依存する代わりに、「ドキュメントを用いたチャット」は、あなたの信頼できる内部リソースに基づく文脈特有の回答と分析を生成します。あなたのドキュメントをアップロードし、これらのドキュメントをチャットの回答基盤として使用してください!
データ制約の解決
言語モデルに質問するとき、モデルが訓練されたデータセットに依存します。これは一般的にインターネット上の情報です。公開されていないソースはおそらくこのデータセットには含まれていません。チャットの情報源としてあなたのドキュメントを使用することで、質問の回答に必要な情報をモデルが確実に保持していることを確認できます。
あなたのドキュメントの利点
自分のドキュメントについて、主要ポイントを挙げる、文書を要約する、などの質問をすることができます。また、独自のデータセットを用いて言語モデルに特定の分析を実行させることも可能です。
ドキュメントベースのチャットの欠点
ドキュメントのアップロードと処理には追加のステップがあり、特定情報の文脈なしで十分に回答を得られる場合には省略できます。また、リクエストを言語モデルに送る前にドキュメントから必要な情報を取得する必要があるため、回答生成には時間がかかります。
どのソースが読まれたかを確認する
回答の下にある ソース では、モデルが使用した内容を確認できます: 全文、抜粋、要約、処理が不完全、または 未読。添付ファイルが自動的に全文読取されるとは限りません。ファイルのすべての部分を扱う必要がある回答を使う前に、この情報を確認してください。
一部選択や要約結果の場合は、章や残りの部分についてより具体的に質問できます。処理が不完全な場合は、まずファイルの状態を確認してください。アシスタント管理者は ソーステキスト で ソースの全文を必須にする を選べます。そうすると、要約は本文の代替として使われません。大きなソースは分割して読み込まれ、消費量が増える場合があります。その場合でも、ソースの通知を確認する必要があります。
ドキュメントベースのチャットに適したモデル
ドキュメントとチャットするには、中央モデルカタログから十分なコンテキスト容量を備えた高品質の言語モデルを選んでください。
適切なモデルは、十分なコンテキスト空間と優れたドキュメント分析能力を備えたものです。OpenAI、Claude、Google、欧州AIの高品質モデルなど。
一つまたは複数のドキュメントを選択
質問バーの右側にあるクリップをクリックしてファイルモードを有効にできます。最大10ファイルまでチャットに使用できます。
ドキュメントでチャットを開始するとき、モデルがドキュメントチャットに適しているかを確認します。適していない場合、現在のカタログから自動的に適切なモデルを選択します。
このドキュメントをチャットする際は、ファイルモードが有効な間続けます。
ファイルごとに処理
ドキュメントでのチャットに加え、AI-Corporate は各ドキュメントに対して別個のプロンプトを適用し、個別の回答を受け取る機能を提供します。この機能は「ファイルごとに処理」と呼ばれます。
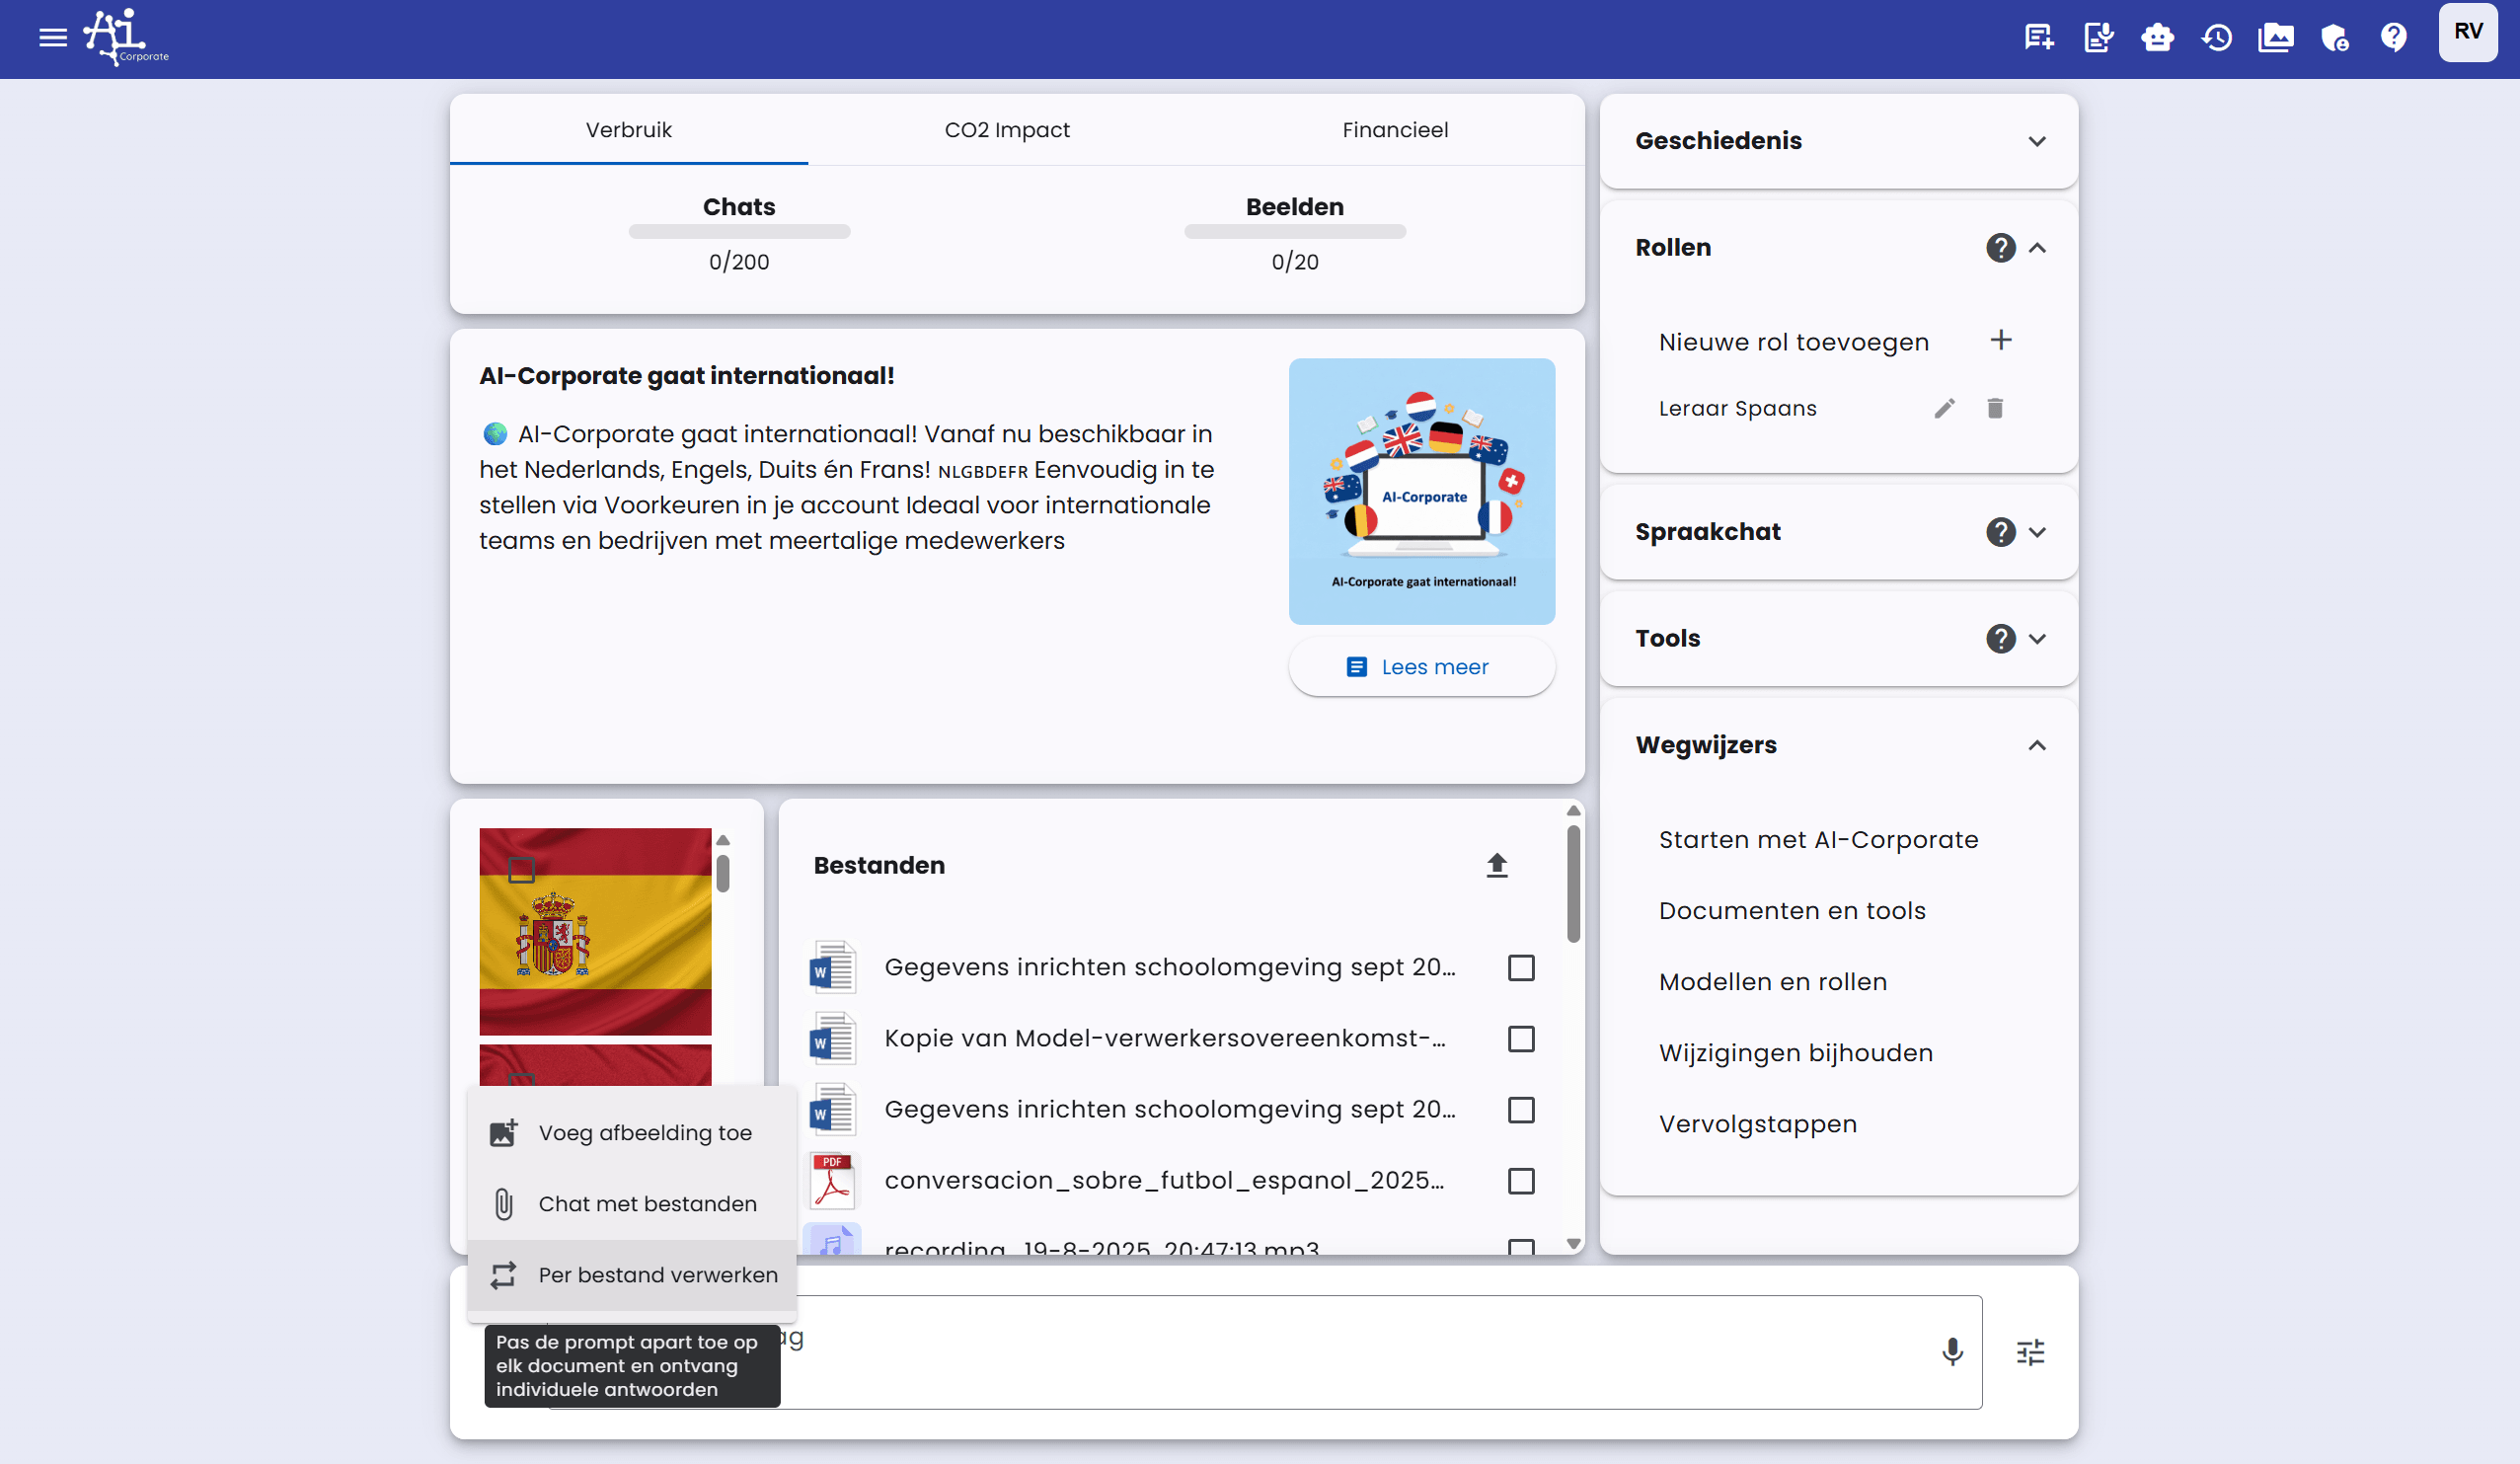
この機能は「ファイルとチャット」を組み合わせて使用可能です。
想定されるシナリオ
「ファイルごとに処理」機能の実用的な例:
- 参照ドキュメント(例:契約テンプレート)をアップロードし、ファイルとチャットに設定する
- 分析すべき複数のドキュメントをアップロードし、ファイルごとに処理に設定する
- すべてのファイルに対して適用されるプロンプトを作成する
この方法で、参照テンプレートに基づいて契約全体を自動分析することができます。
「ファイルごとに処理」機能には最大30ファイルの制限があります。
サポートされるファイルタイプ
AI-Corporateはドキュメントとのチャットのため、以下のファイルタイプをサポートします:
- .pdf のPDFファイル
- .docx のWordファイル
- .csv のCSVファイル
- .json のJSONファイル
- .txt のテキストファイル
- 拡張子が 'mp3', 'mp4', 'mpeg', 'mpga', 'm4a', 'wav' または 'webm' の音声・動画ファイル
音声または動画ファイルとのチャット
AI-School は音声・動画ファイルをまず設定済みの文字起こしプロバイダーでテキスト化します。会話では、結果に時間ブロックや話者ラベルが含まれることがあります。その後、適切なテキストモデルで句読点、スペル、話者ラベル、専門用語を修正できます。長いファイルはプロバイダーやモデルの制限により短いファイルと異なる処理になる場合があります。
中央ナレッジベース
公開済み文書は組織または学校の範囲内で自動検索され、所有権は組織に保持されます。
- Markdown文書を作成
- ソースファイルを追加
- OKFバンドルをインポート / OKFバンドルをエクスポート
- 公開状態: 下書き, 公開済み, アーカイブ済み
- 範囲: 組織全体 / 選択した学校
学校管理者が管理できるのは自校の文書のみです。組織管理者は組織全体のナレッジも管理できます。
移植可能なOKF知識にはYAMLフロントマターと通常のMarkdownリンクを使用してください。
